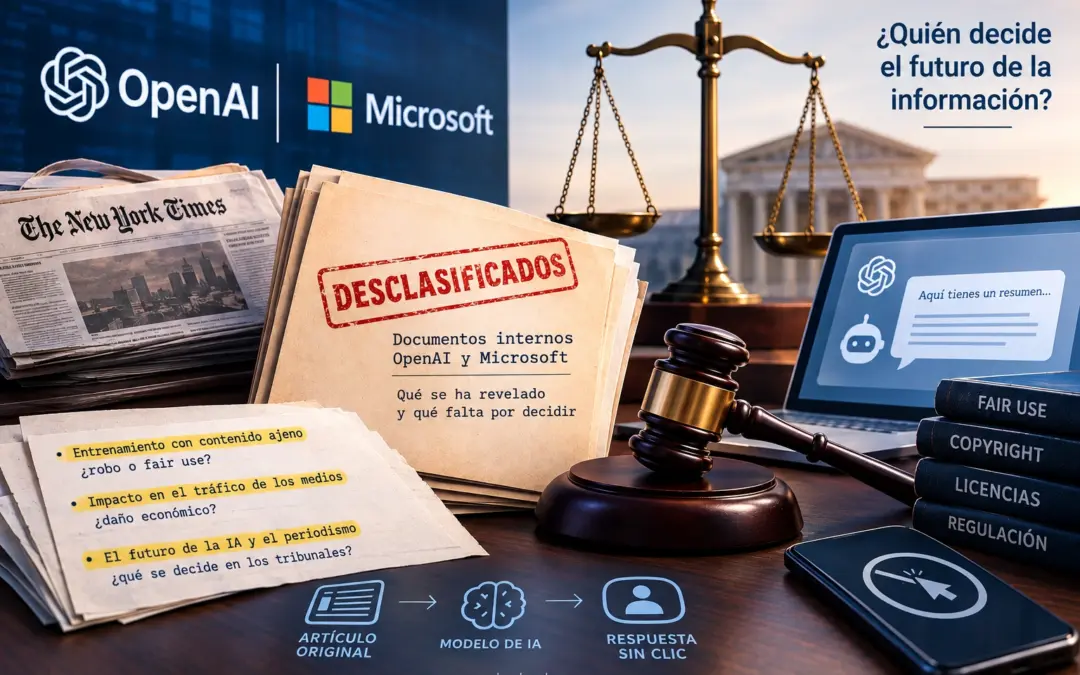
Esta semana se han hecho públicos documentos internos de OpenAI y Microsoft que hasta ahora estaban bajo sello judicial. Forman parte de la demanda que The New York Times presentó en diciembre de 2023 y a la que después se sumaron otros once medios. Las mociones de juicio sumario están siendo evaluadas por el juez Sidney Stein, del Distrito Sur de Nueva York. Conviene empezar por una precisión: lo publicado son extractos de escritos de la parte demandante. Son alegaciones y pruebas aportadas, no sentencias.
Lo que dicen los documentos
El fragmento más citado es un memorando de enero de 2023 de Brent Hecht, director de Ciencia Aplicada de Microsoft. Calificaba el entrenamiento con artículos ajenos como un robo asombroso de proporciones sin precedentes, y en otro pasaje lo describía como el mayor robo de trabajo de la historia. Hecht advertía también de un «bucle idiotizador»: si la web se llena de contenido generado por chatbots, los modelos futuros tendrán menos material original con el que aprender
Los demandantes señalan además un intercambio en OpenAI. Un ingeniero, Nick Ryder, informó al presidente Greg Brockman de que había encontrado un truco para saltarse el muro de pago del Times, y Brockman respondió con un escueto «qué bien». Según los escritos, tampoco existía una política para evitar descargar contenido protegido ni para retirarlo después de los conjuntos de entrenamiento, y Microsoft habría tenido acceso a los datos usados para GPT-3 antes de alojar los modelos en su nube. Los abogados sostienen también que los conjuntos WebText y WebText2 estaban sesgados hacia contenido periodístico, que se obtuvieron millones de artículos de Common Crawl y que se intentaron eliminar avisos de copyright antes del entrenamiento.
Hay un matiz técnico relevante. Según el relato de los demandantes, OpenAI no aplicó controles sobre las páginas descargadas hasta septiembre de 2023, casi un año después de lanzar ChatGPT, y los reforzó en enero de 2025. El mecanismo de exclusión, el archivo robots.txt, es un acuerdo voluntario y no una barrera técnica: solo funciona si el rastreador decide respetarlo. Los abogados del Times afirman que hubo investigadores que crearon una vía para ignorarlo.
Lo que se sabe de la otra parte
El único contrapunto interno que aparece es el de Satya Nadella. En su declaración, el CEO de Microsoft afirmó que todo lo que esté tras un muro de pago debería licenciarse para quien quiera usarlo, y que de haber sabido que OpenAI había entrenado con ese material habría exigido reentrenar los modelos. En la misma declaración, Nadella reconoció que los chatbots han sustituido en parte el uso tradicional, al dar la información directamente sin que el usuario visite la fuente.
OpenAI y Microsoft niegan las acusaciones. Su defensa sostiene que las leyes y los precedentes vigentes permiten rastrear obras públicas para entrenar modelos de lenguaje y que los hechos noticiosos no están protegidos por copyright. OpenAI argumenta que el entrenamiento transforma los artículos en obras nuevas en lugar de reemplazarlos. Es la esencia del fair use, y esa es la cuestión que el tribunal debe resolver, no el tono de los correos.
El efecto sobre el tráfico
Aquí los datos internos pesan más que las frases. Según cifras de Microsoft recogidas en el caso, quien accedía a contenido del Times a través de Copilot tenía entre un 87 % y un 91 % menos de probabilidades de pinchar un enlace que quien usaba un buscador tradicional. Nick Turley, responsable de producto de ChatGPT, escribió en 2023 que la IA era una amenaza existencial para el periodismo y en 2024 que los productos de IA son «en gran medida sustitutivos». Este es el eje de la cuarta condición del fair use: el efecto sobre el mercado de la obra original. Es un argumento potente para los medios, aunque la correlación entre respuestas de IA y clics no equivale por sí sola a una prueba de daño económico.
Dónde está el proceso
El Times presentó la demanda el 27 de diciembre de 2023, tras romperse las negociaciones de licencia. En marzo de 2025, Stein desestimó algunas reclamaciones pero dejó vivas la mayor parte, incluidas las de infracción directa y contributiva. El caso está integrado en un litigio multidistrito con otros medios y autores, y en él se ordenó a OpenAI conservar y producir millones de registros de conversaciones de ChatGPT; las cifras citadas hablan de 20 millones. A principios de septiembre de 2026 las tres partes presentaron sus argumentos de juicio sumario, y se espera una decisión en los próximos meses sobre si el caso, o partes clave, irá a juicio el año que viene. Mientras tanto siguen llegando demandas: el 16 de septiembre se presentó otra de varios periódicos contra OpenAI y Microsoft, la número 143 contra empresas de IA según un rastreador especializado.
El contexto jurídico: nada está cerrado
Los tribunales han dado señales contradictorias. En Bartz contra Anthropic, el juez consideró que entrenar con libros adquiridos legalmente es fair use, pero no almacenar copias pirata, y el caso terminó con un acuerdo de 1.500 millones de dólares. El juez Chhabria falló a favor de Meta en Kadrey, aunque con una argumentación sobre «dilución de mercado» que deja la puerta abierta a futuras reclamaciones. En sentido contrario, el juez Bibas rechazó el fair use en Thomson Reuters contra Ross. Esa apelación se vio en el Tercer Circuito el 11 de junio de 2026 y, a 1 de septiembre, ningún tribunal de apelación de EE. UU. había resuelto la cuestión. En Europa, un tribunal de Múnich ya se ha pronunciado en el caso GEMA contra OpenAI, y el Reglamento de IA de la UE añade obligaciones de transparencia sobre los datos de entrenamiento.
También existe el camino de la licencia: OpenAI mantiene acuerdos con editores, entre ellos Axios, lo que muestra que el mercado de licenciar contenido para IA ya funciona, con precedentes que las partes usarán en sus argumentos.
Lectura técnica
- Para quienes trabajamos con webs, hay tres conclusiones prácticas. Primera: robots.txt expresa una preferencia, no una protección, y el muro de pago solo ataca el acceso, no el uso posterior.
- Segunda: si las respuestas generadas sustituyen a la visita, el modelo de negocio basado en tráfico y publicidad queda tocado aunque nadie gane en los tribunales.
- Tercera: la licencia, la atribución con enlace y los estándares de exclusión verificables serán probablemente el terreno donde se resuelva esto, ya sea por sentencia, por acuerdo o por regulación.
Ni «el mayor robo de la historia» ni «uso legítimo» son todavía conclusiones judiciales. Lo son las pruebas: ahora que se pueden leer, cualquiera puede valorarlas con más criterio que con titulares.